

近日,亿欧智库正式发布《2026世界模型行业研究报告——世界模型六大能力模块与五大应用场景盘点》,围绕世界模型的技术演进、核心能力、应用场景及未来趋势进行系统梳理。报告认为,世界模型并不等同于视频生成工具,而是面向物理世界的AI基础底座;当前产业正脱离纯学术原型阶段,进入技术验证与场景落地并行推进的窗口期。
凭借 Visics通用具身大模型、RoboMirage物理仿真引擎 为核心的技术体系,以及在跨本体操作与云端EaaS具身智能服务方面的领先实践,RoboScience机器科学成功入选该报告,展现了世界模型从技术能力走向具身智能实际应用的代表性路径。此外,RoboScience机器科学还获得了亿欧WRC具身智能商业化论坛组委会颁发的 “2026全球具身智能标杆企业 Top 100” 称号。
01首创VLOA架构,Visics打通具身操作闭环
亿欧报告将世界模型的技术框架概括为 “Vision-Memory-Controller”,其核心在于让AI不只感知当前状态,还能理解世界变化并预判未来。但报告同时指出,当前世界模型通常侧重于状态预测,难以直接输出端到端的动作指令,从”预判未来”到”物理执行”之间仍存在脱节。
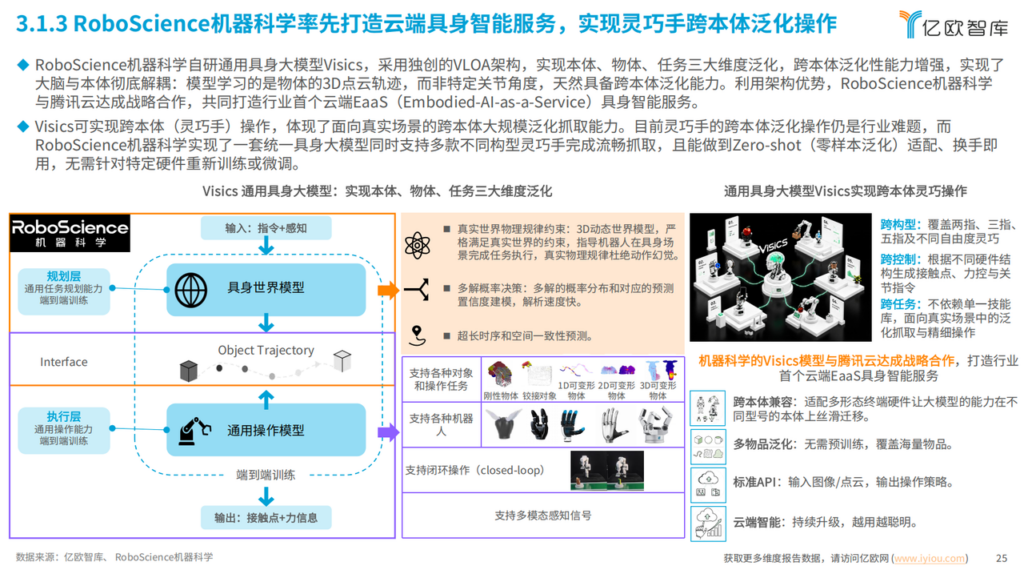
为攻克这一难题,RoboScience机器科学自研了Visics通用具身大模型,并创新性提出以物体为中心的 VLOA(Vision-Language-Object-Action)架构。该架构由两大引擎组成:具身世界模型负责接收感知与指令,理解环境并预测被操作物体未来的3D动态轨迹;通用操作模型负责物理执行,将预测轨迹进一步转化为机器人可执行的接触点与力信息。
得益于VLOA架构,Visics实现了大脑与本体的彻底解耦 —— 模型学习的是物体的3D点云轨迹而非特定硬件的关节角度,从而天然具备了 跨本体、跨任务、跨物体 三大维度的泛化能力。
亿欧智库在报告中特别以RoboScience的灵巧手跨本体泛化操作为例:Visics不仅能同时支持多款不同灵巧手完成流畅抓取,更做到了 Zero-shot(零样本泛化) 适配,换手即用,无需重新训练或微调,率先突破了这一行业公认难题。
02″仿真+视频”双数据飞轮,突破具身智能数据瓶颈
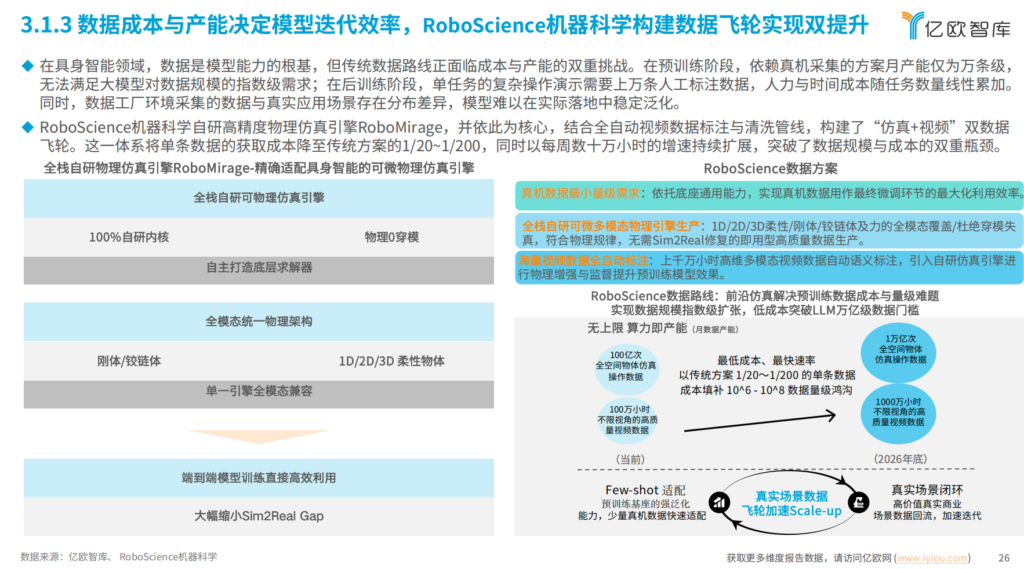
亿欧智库指出,在具身智能领域,数据是模型能力的根基,但传统数据路线正面临成本与产能的双重挑战:预训练阶段,依赖真机采集的方案月产能仅为万条级,难以满足大模型对数据规模的需求;后训练阶段,单任务复杂操作演示需要上万条人工标注数据,人力与时间成本随任务数量线性累加。
针对这一问题,RoboScience机器科学自研可微多模态物理仿真引擎 RoboMirage,并以此为核心,结合全自动视频数据标注与清洗管线,构建“仿真+视频”双数据飞轮。RoboMirage支持刚体、铰链体以及 1D、2D、3D 柔性物体等不同对象,并对复杂物理接触进行统一建模,为机器人源源不断生成真实、低成本的训练数据。
亿欧智库以数据成本与产能决定模型迭代效率,RoboScience机器科学构建数据飞轮实现双提升”为题介绍这一数据体系。报告显示,该体系将单条数据获取成本降低至传统方案的 1/20~1/200,同时以每周数十万小时的增速持续扩展,突破数据规模与成本的双重瓶颈。这一路径将具身智能的数据生产从高度依赖真机与人力,进一步扩展至由视频、仿真共同驱动,并通过真实场景数据回流持续反哺模型迭代。
03从跨本体到云端EaaS,让具身智能走向规模化复用
从技术验证走向规模化商用,具身智能必须跨越“场景泛化”这一关。现实中,机器人端侧形态高度多样,硬件本身难以完全统一。因此,能否以更低成本适配更多机器人,成为规模化部署的关键。
基于VLOA灵活的架构,Visics实现了大脑与本体彻底解耦,成为全球首个云端具身大模型,并已与腾讯云达成战略合作,共同打造行业首个云端EaaS(Embodied-AI-as-a-Service)具身智能服务,标志着具身大模型正式脱离单一硬件约束,以纯软件方式交付,为行业定义”云原生具身智能”的技术范式。开发者可像调用云端API一样调用操作能力,无需自研模型,也无需从头搭建数据与训练体系。
从Visics对物理世界进行理解与动作预演,到RoboMirage通过“仿真与视频”持续扩展训练数据,再到云端EaaS推动具身智能的规模化复用,RoboScience机器科学已构建起“世界理解—未来预演—物理执行—数据回流”的完整技术闭环。
正如亿欧智库所言,世界模型正处于向产业落地跨越的关键窗口期。未来,RoboScience将持续迭代大模型、仿真引擎及机器人本体,推动具身智能从单点操作迈向长程复杂任务,在更多真实商业场景中加速落地。