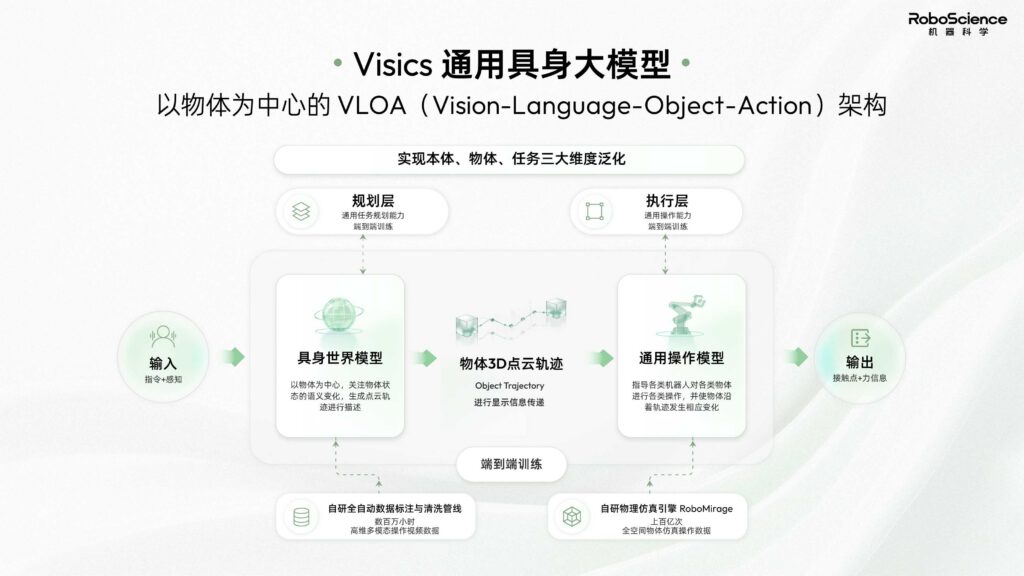
Visics 通用具身大模型
通用具身大模型 Visics,采取以物体为中心,融合世界模型与通用操作模型的 VLOA(Vision-Language-Object-Action)架构,实现本体、物体、任务三大维度泛化,上层具身世界模型负责认知和预演物理轨迹,下层通用操作模型负责将轨迹转化为不同机器人的物理控制信号,实现了高层语义与底层物理规律的完美解耦,并分别用海量互联网视频及仿真数据进行预训练。
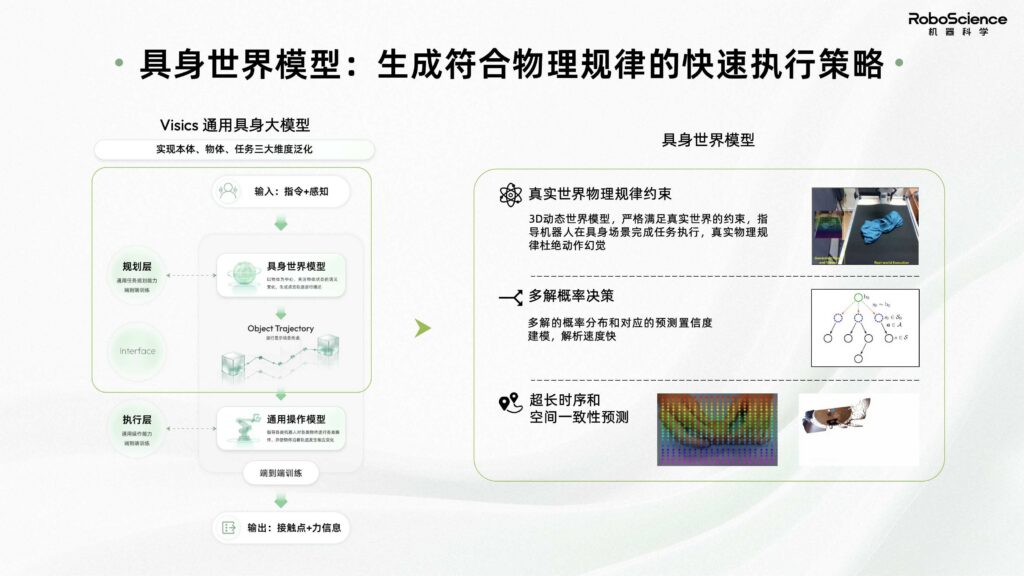
- 具身世界模型
相比当前以视频预测为中心的世界模型路线,RoboScience机器科学的具身世界模型是以物体交互为中心且3D动态的,架构更接近机器人真实执行所需的底层表示。其核心并不是在VLA之上外挂一个视频生成模块,不需要渲染宏大的世界,也不需要到像素级别,而是围绕具身操作所需的物体级状态、三维轨迹、接触关系和物理因果变化构建世界模型,并与执行层(通用操作模型)形成统一闭环。
模型的预训练基于海量互联网视频数据。通过全自动数据标注及清洗pipeline,团队已积累数百万小时以物体为中心的高维多模态操作相关数据集(数千万video clips),并以每周数十万小时的速度增长,目标在2026年构建上千万小时的全球领先数据集。
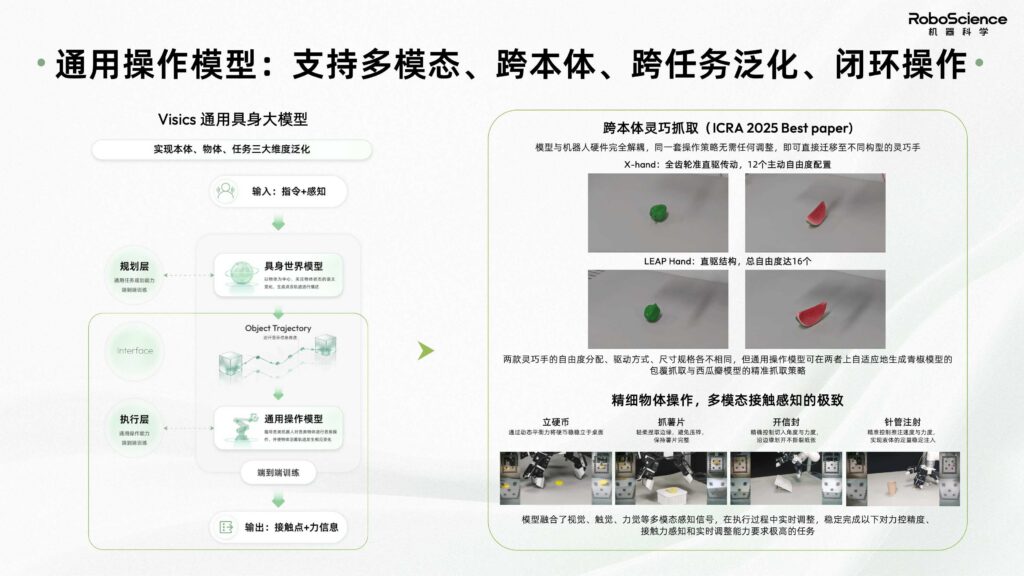
- 通用操作模型
模型通过「物理引擎-仿真数据-端到端训练」的高效闭环,解决泛化性与灵巧操作难题。可支持刚体、铰链体、1D/2D/3D可形变体等全空间物体的各类操作任务;支持跨本体,支持不同类型的各种机器人及末端执行器;支持闭环操作(closed-loop);支持含视觉、触觉、力觉等多模态感知数据。
作为通用操作模型学习物理规律的基础,我们通过自研多模态物理引擎RoboMirage积累了数百亿次高质量manipulation操作轨迹数据集,2026年目标是构建超过1T高质量manipulation操作轨迹数据集(1万亿次全空间物体的manipulation操作轨迹数据)。
基于VLOA大模型,RoboScience于2025年5月完成全球范围内最复杂、精度最高、步骤最多的具身操作任务
拼家具过程中几乎包括了领域中的所有难点:手内操作、外部灵巧性、双臂协同操作、精准力控、物体重排、部件嵌入/插入等,且拼家具对于精度要求极高,达到毫米级。
模型读取说明书后即可启动拼装:深度理解零件结构逻辑,实现多部件的检测、感知、插拔与旋转配合,还能自主分解多步骤任务,完成多关节双臂协同运动。
依托自适应插接路径规划和精细接触力调控策略,系统成功实现了高精度、高稳定性的拼装过程,无论是在零部件定位还是微小运动控制上均表现出卓越的能力。通过实时获取插接产生的反馈力,模型还能动态调整操作策略。
即便拼装过程中遭用户拆解干扰,模型仍能自动恢复状态,接续完成后续拼装步骤。通过该框架,系统可以用标准化方法分析不同场景下的物理接触,例如机器人抓取物体时的力反馈、变形预测或运动规划,无需为每种对象或机器人单独开发算法。